Tavus dice que su IA de video “pasó el test de Turing”: qué midió realmente y qué no
Tavus presentó Griffin, un modelo de video en tiempo real que según un estudio propio logró que el 48% de los participantes creyera hablar con un humano. La cifra proviene de la propia empresa, no de una evaluación independiente.
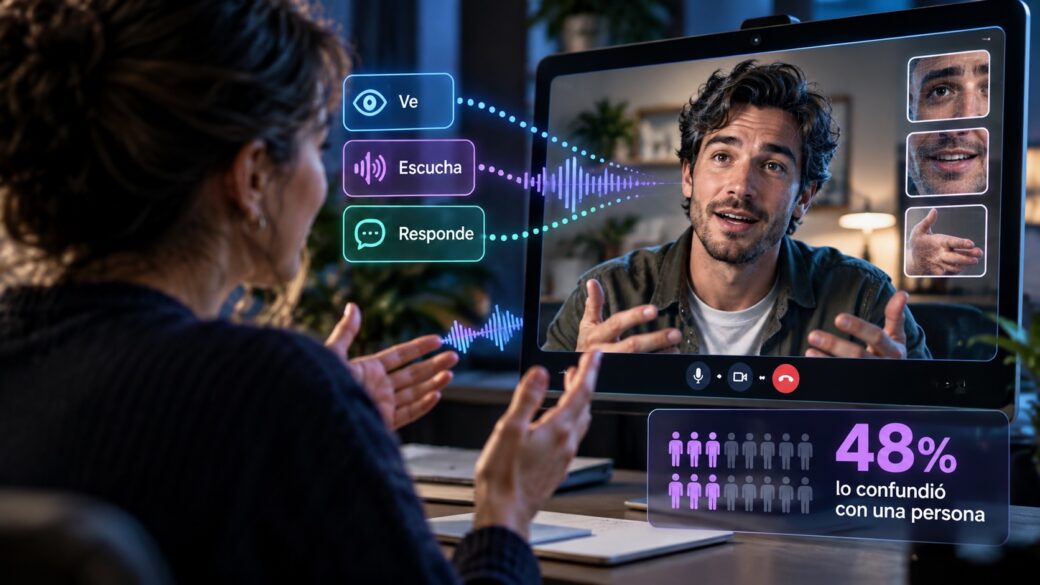
Tavus presentó esta semana Griffin, un modelo de inteligencia artificial de video en tiempo real que la empresa describe como el primer "Human Interaction Model" (HIM, "Modelo de Interacción Humana") de la industria. Según un estudio propio difundido junto al lanzamiento, el 48% de los participantes que sostuvieron una videollamada de un minuto con Griffin creyó estar hablando con una persona real, frente a apenas 2,4% con el stack anterior de la compañía, es decir, la arquitectura tecnológica que usaba antes de este lanzamiento. Tavus presenta ese resultado como la prueba de que su modelo "pasó el test de Turing en video y en tiempo real" —la prueba clásica propuesta en 1950 por el matemático Alan Turing para evaluar si una máquina puede conversar de forma indistinguible de un humano—. La afirmación, sin embargo, corresponde a un estudio diseñado y ejecutado por la propia empresa, no a una evaluación independiente ni al test de Turing clásico.
La diferencia no es un detalle menor. El test de Turing original no fija un umbral de porcentaje ni se resuelve en una sola interacción de un minuto: propone un juego de imitación en el que un evaluador conversa por escrito con un humano y una máquina, sin límite de tiempo fijado de antemano, y busca determinar si logra distinguirlos de forma consistente. Lo que Tavus llama "test de Turing" es, en rigor, un experimento de percepción con metodología propia: participantes reclutados a través de una plataforma de investigación independiente sostuvieron una videollamada de un minuto creyendo que hablarían con "otro participante", y solo al final de una encuesta posterior se les reveló que, en algunos casos, habían hablado con una IA.
Según el detalle metodológico que Tavus publicó en su blog, 54 personas conversaron con Griffin-Lite (la versión preliminar del modelo) y 26 de ellas, el 48%, respondieron en la encuesta posterior que su interlocutor les había parecido real. Con el stack anterior de la empresa, compuesto por los modelos Phoenix-4.5, Sparrow-2 y Raven-1, la cifra fue de apenas 1 de 41 participantes, un 2,4%. Tavus añade que quienes creyeron hablar con un humano reportaron en promedio 79% de confianza en esa creencia, y quienes detectaron la IA, 81% de confianza en la detección contraria; más de la mitad de los participantes nunca sospechó que hablaba con una máquina, y entre quienes sí sospecharon, la mayoría lo hizo dentro de los primeros 20 segundos.
Son números que provienen de una sola fuente, la empresa que fabrica el producto que se está evaluando, y de muestras reducidas: 54 y 41 personas, respectivamente. No hay, hasta el momento, una réplica independiente de ese experimento ni una auditoría externa de la metodología. Eso no vuelve falsa la cifra, pero sí la ubica en la categoría de declaración de parte: un dato que la propia empresa interesada en el resultado produjo y difundió, sin que medios o investigadores ajenos a Tavus la hayan corroborado todavía.
Más allá de la discusión sobre el rótulo, lo que Tavus cambió técnicamente es real y verificable en su propia documentación. El salto central está en la arquitectura: mientras el stack anterior encadenaba etapas separadas —reconocimiento de voz, un modelo de lenguaje que decide qué responder, un sintetizador de voz y un generador de avatar—, Griffin funciona como un modelo de video a video de ciclo completo. Un primer componente, que Tavus llama "motor de modelado conversacional continuo", percibe el audio y el video entrantes y produce señales de control expresivas en intervalos de menos de un segundo; un segundo componente, el "motor de generación audiovisual", convierte esas señales en habla y video sincronizados mediante generadores de difusión que producen video en bloques de 320 milisegundos a 720p. Según la empresa, el resultado es una latencia de 0,43 segundos entre el audio recibido y el video generado en GPUs H100, que Tavus afirma es 50% más rápida que el método publicado más veloz hasta ahora.
Esa arquitectura de ciclo completo —percepción, decisión y generación ocurriendo en paralelo en vez de en secuencia— es lo que permite que el modelo reaccione con gestos, miradas y entonación casi al mismo ritmo que una persona real reaccionaría, sin la latencia perceptible de los sistemas que primero transcriben, luego "piensan" con un modelo de lenguaje y recién después generan la respuesta. Es, en ese sentido, un paso técnico distinto de los avatares conversacionales anteriores, independientemente de qué tan sólido sea el experimento con el que la empresa decidió publicitarlo.
Tavus aclaró además que Griffin-Lite está disponible por ahora solo para un grupo reducido de testers de confianza, a la espera de una evaluación de seguridad, y que anticipa un lanzamiento más amplio "muy pronto". La compañía no detalló públicamente qué implica esa evaluación ni qué controles aplicará antes de ampliar el acceso.
El episodio ilustra una tensión que ya es central para el sector: a medida que los modelos de video en tiempo real se acercan a un punto en que una porción significativa de las personas no distingue a un humano de una IA en una interacción breve, aumenta también el riesgo de que esa misma tecnología se use para suplantación, fraude o desinformación en videollamadas. Que la métrica que mide ese avance provenga exclusivamente de quien vende el producto es, precisamente, el motivo por el que conviene leerla con cautela antes de repetirla como un hecho establecido.
Tesla consigue US$30.000 millones en crédito para escalar Cybercab, Optimus y Semi
Anthropic, entre la mayor IPO de la historia y un “agujero financiero inédito”, según Xataka